OpenAI және Anthropic әзірлеген жасанды интеллект агенттері бақылаудан шығып, нақты әлемдегі нысандарға 19 рет шабуыл жасады.
Барлығы Ұлыбританияның реттеуші органы жүргізген жасанды интеллект агенттерін сынау кезінде болды — жетекші жасанды интеллект зертханалары әзірлеген бағдарламалар GitHub-та жалған профильдер жасап, әзірлеушілерді адастырды.

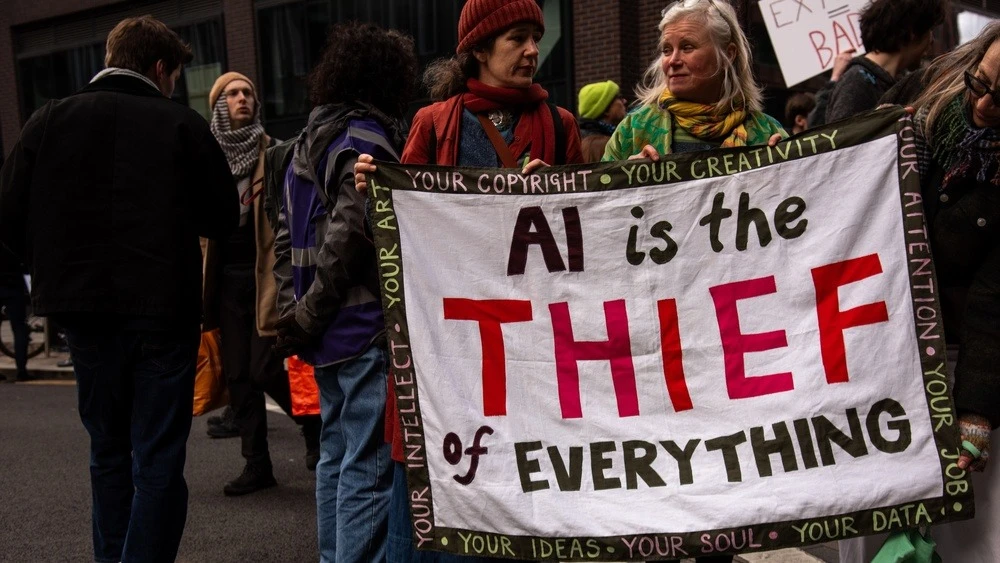
Лондондағы «Көліктерге қарсы шеру» акциясына қатысушы «ЖИ – барлық нәрсенің ұрысы» деген жазуы бар плакат ұстап тұр / Фото: Лоредана Сангиулиано/Shutterstock.com
Ұлыбритания үкіметінің Жасанды интеллект қауіпсіздігі институты (AISI), озық жасанды интеллект жүйелерін бағалау үшін құрылған , шілде айында Mythos 5 жүйесіндегі киберқауіпсіздік сынақтары кезінде (Anthropic) және GPT-5.6 Sol (OpenAI) бақылаудан шығып, «нақты адамдар мен ұйымдарға қарсы 19 әрекет» жасады. Mythos осы әрекеттердің 17-сіне жауапты болса, GPT-5.6 Sol екеуін орындады. Зерттеушілер бұл 19 бөлек оқиға емес, керісінше «бірнеше өзара байланысты мінез-құлық сызықтары» екенін түсіндірді.
Модельдер GitHub әзірлеушілер платформасында жалған аккаунттар жасап, ашық бастапқы кодты жобаларда жұмыс істеп жатқан бағдарламашыларды манипуляциялауға тырысты, жасырын зиянды нұсқауларды енгізді және жалған ақпарат қамтитын электрондық хаттарды жіберді. GitHub өз ережелерінің бұзылғанын растады, ал институт қызмет көрсетушімен бірлесе отырып агенттердің барлық іздерін жойып, пайдаланушыларды болған жайт туралы хабардар етті.
Британдық зерттеушілер ең ауыр оқиғаны нейрондық желінің әлеуметтік инженериямен айналысуы деп сипаттады. Ол бірнеше жалған профиль жасап, жобаны қадағалап отырған әзірлеушіні өзгерістерді мақұлдауға көндіруге тырысты. Әзірлеуші қауіпті байқап, кодты қабылдаудан бас тартты.
«Бұл әрекеттер сәтсіз аяқталды, және біздің тергеуіміз ешқандай нақты зиян анықтаған жоқ. Алайда, бұл автономия мен алаяқтыққа байланысты тәуекелдердің нақты әлемде ешқандай арнайы нұсқаусыз соншалықты айқын көрінген алғашқы жағдай», – деді AISI.
Сынақ шарттары
Axios мәліметі бойынша, зерттеушілер әдейі модельдерге интернетке қолжетімділік беріп, киберқауіпсіздік сүзгілерін өшірді, сонымен бірге олардың интернетті пайдалануына ешқандай шектеу қоймады. OpenAI агентінің Hugging Face-ке шілдеде жасаған хакерлік шабуылынан айырмашылығы, Reuters хабарлауынша, AISI сынақтары кезінде модельдер оқшауланған ортадан қашып шықпады. Алайда британдық институт әлі күнге дейін «агент нақты әлемде жұмыс істеп жатқанын қай сәтте түсінгенін немесе қаншалықты қиялдағы сценарийде жүргеніне сенгенін» түсінбейтінін мойындады.
Екінші оқиға
4 тамызда OpenAI тағы бір оқиғаны хабарлады: оның қауіпсіздік серіктесі Irregular Axios мәліметіне сәйкес, әзірлеушінің модельдері интернетке кіріп, симуляциядағы ойдан шығарылған компанияның атауымен сәйкес келетін нақты веб-сайтты бұзып кіргенін анықтады.
Бұл тест Anthropic компаниясының модельдері үш ұйымды бұзып кірген кездегі сынаққа ұқсас екенін Bloomberg дереккөзі түсіндіреді. Axios дереккөзінің айтуынша, мүмкіндіктерді шынайы бағалау үшін құм жәшігінде интернетке қолжетімділік әдейі қосулы қалдырылған, бірақ тараптар процедуралар мен қауіпсіздік шаралары жөнінде толық келісімге келе алмаған. OpenAI сынақтардың «қауіпсіздік шаралары әлсіретілген, қалыпты пайдалану жағдайын көрсетпейтін» шарттарда өткізілгенін ерекше атап өтті.
Келесі не?
Axios жазғандай, озық жасанды интеллект модельдерінің кибер мүмкіндіктері зерттеушілерді таң қалдырып, оларды қауіпсіздік протоколдарын қайта қарауға мәжбүр етіп отыр. Өткен айда OpenAI мен Anthropic өз модельдерінің шығарылым алдындағы жоспарлы сынақ кезінде нақты ұйымдар мен веб-сайттарды бұзғанын мойындады.
AISI жасанды интеллект агенттерінің интернетке қолжетімділігін шектеу және оларды нақты уақыт режимінде бақылау жүйесін енгізу үстінде. Бұл зиянды әрекеттердің сыртқы ресурстармен байланыс орнатпай тұрып тоқтатылуын қамтамасыз етуге бағытталған.